


목차
데이터 다루기
•
인덱스에 실제로 문서를 색인, 조회, 업데이트, 삭제하는 방법에 대한 학습
•
다양한 검색쿼리, 페이지네이션, 집계에 대해서 학습
•
JVM 서비스 코드에서 ES Client를 이용해 ES API를 호출하는 방법 학습
색인
PUT [인덱스 이름]/_doc/[_id값]
POST [인덱스 이름]/_doc
PUT [인덱스 이름]/_create/[_id값]
CREATE [인덱스 이름]/_create/[_id값]
Bash
복사
•
ID값이 있다면 PUT, 이미 해당 _id값으로 문서가 있다면 덮어씌운다
•
ID값이 없다면 POST, _id는 ES에서 임의 지정
•
_create는 항상 새 문서를 생성하며 _id가 이미 존재하면 덮어쓰기 하지 않고 실패한다.
refresh
•
색인 시 refresh 매개변수를 통해 색인 직후 샤드 refresh를 수행해 즉시 검색 가능 여부를 설정할 수 있다.
•
refresh 속성
◦
true: 색인 직후 문서가 색인된 shard refresh하고 응답 반환
◦
wait_for: 색인 이후 refresh 될 때까지 기다린 후 응답 반환
◦
false(default): refresh 동작을 수행하지 않는다.
•
잦은 refresh는 비용낭비일뿐 아니라 크기가 작은 세그먼트가 많이 생성될 수 있어 검색 성능도 떨어진다.
•
문서 색인 요청 결과가 검색 역색인에 즉시 동시적으로 반영되야 하는 요청을 최소화하도록 설계하자.
•
즉시 확인이 필요한 경우 검색보단 조회 API를 활용하자.
•
대량의 색인이 필요한 경우 bulk API를 사용하자
조회
GET [인덱스 이름]/_doc/[_id값]
GET [인덱스 이름]/_source/[_id값]
Bash
복사
•
_doc은 인덱스나 _id와 같은 메타데이터를 같이 조회한다.
•
_source는 문서의 본문만을 반환한다.
조회 - 필터링
•
_source_includes, _source_excludes 옵션으로 필드 필터링을 할 수 있다.
GET my_index2/_source/1?_source_includes=p*,views
# 검색 결과
#{
# "views": 1234,
# "public": true,
# "point": 4.5
#}
GET my_index2/_source/1?_source_includes=p*,views&_source_excludes=public
# 검색 결과
#{
# "views": 1234,
# "point": 4.5
#}
Bash
복사
•
_source_includes 만 사용할때는 _source로 줄여서 사용할 수 있다.
업데이트
POST [인덱스 이름]/_update/[_id값]
Bash
복사
•
doc을 이용해 업데이트하기
POST [인덱스 이름]/_update/[_id값]
{
"doc": { [업데이트할 내용] }
}
Bash
복사
◦
detect_noop 속성을활용하자
▪
변경 요청은 했지만 실제로 변경된게 없는 경우를 noop이라 하는데, 데이터 특성상 noop이 발생하 ㄹ가능성이 없는 경우 noop 설정을 비활성화해서 약간의 성능 향상을 할 수 있다.
◦
doc_as_upsert를 활용하자
▪
SQL의 upsert와 같은 동작을 하도록 한다. default는 false이다.
•
script를 이용해 업데이트하기
put update_test/_doc/1
{
"title":"hello world",
"views": 35,
"created":"2019-01-17T14:05:01.234Z"
}
POST update_test/_update/1
{
"script":{
"source": "ctx._source.views += params.amount",
"lang":"painless",
"params":{
"amount":1
}
},
"scripted_upsert": false
}
get update_test/_doc/1
Bash
복사
ES 자체 스크립트 painless를 이용해 스크립트를 작성해 업데이트 할 수 있다.
삭제
DELETE [인덱스 이름]/_doc/[_id값]
Bash
복사
복수 문서 API
bulk API
•
여러 색인, 업데이트, 삭제 작업을 한 번의 요청에 담아서 보내는 API
•
JSON이아니라 NDJSON형태로 데이터를 만들어 보낸다.
◦
Content-Type도 application/x-ndjson을 사용해야 한다.
◦
마지막 줄도 줄바꿈 문자 \n으로 끝나야 한다.
POST _bulk
{"index":{"_index":"bulk_test","_id":"1"}}
{"field1":"value1"}
{"delete":{"_index":"bulk_test","_id":"2"}}
{"create":{"_index":"bulk_test","_id":"3"}}
{"field1":"value3"}
{"update":{"_index":"bulk_test","_id":"1"}}
{"doc":{"field2":"value2"}}
{"index":{"_index":"bulk_test","_id":"4", "routing":"a"}}
{"field1":"value4"}
Bash
복사
•
bulk API 는 기본적으로 순서를 보장하지 않는다. 순서를 가지도록 하고 싶을 경우 인덱스, _id, 라우팅 조합을 동일하게 가져간다면 요청들은 모두 동일한 주 샤드로 넘어갈테고 순서대로 수행될 수 있다.
multi get
•
한 번에 여러 문서를 조회할 수 있다.
GET _mget
GET [인덱스 이름]/_mget
Bash
복사
GET _mget
{
"docs": [
{
"_index":"bulk_test",
"_id":1
},
{
"_index": "bulk_test",
"_id": 4,
"routing":"a"
},
{
"_index":"my_index2",
"_id":"1",
"_source": {
"include": [ "p*" ],
"exclude": [ "point" ]
}
}
]
}
GET bulk_test/_mget
{
"ids": ["1", "3"]
}
Bash
복사
update by query
•
검색 쿼리 조건에 맞는 복수 문서를 찾아 업데이트 및 삭제 작업을 수행할 수 있다.
•
script를 통한 업데이트만을 지원한다.
•
검색 결과 문서들에 대해 스냅샷을 찍고 업데이트를 진행하는데, 업데이트 작업 중 스냅샷을 찍웠던 문서에서 다른 요청으로 인해 변경이 생겨 버전 충돌 문제가 생기면 그만두거나 다음 작업으로 넘어가거나 선택할 수 있다.
◦
conflicts 매개변수를 지정해 동작을 지정할 수 있다.
◦
abort (충돌 시 중단), proceed (다음 작업으로 진행)
POST [인덱스 이름]/_update_by_query
{
"script": {
"source": " //..",
},
"query": {
//...
}
}
Bash
복사
update by query - 스로틀링
•
update 작업은 운영 중인 서비스에 영향을 줄 수 있기에 스로틀링을 통해 작업 속도를 조정할 수 있다.
◦
클러스터 부하와 서비스 영향을 최소화하는 목적
POST [인덱스 이름]/_update_by_query
?scroll_size=1000
&scroll=1m
&requests_per_second=500
{
//...
}
Bash
복사
◦
scroll_size: 한번에 가져올 업데이트 대상 문서의 갯수
◦
scroll: 검색 조건을 만족한 모든 문서에 대한 상태를 검색 문맥(search context)를 보존할 시간
◦
requests_per_second: 초당 수행할 작업의 갯수
▪
위 설정(1000, 500)기준으로는 ES는 2초마다 스크롤 한 번 분량만큼 업데이트 한다.
▪
1000개에 문서에 대한 업데이트 작업 수행 시간이 0.5초일 경우 작업 수행 후 1.5초를 대기하면 총 2초간 1000개를 업데이트 한 것이 되어 초당 500개의 작업을 수행한 것이 된다.
비동기적 요청과 tasks API
•
update by query 작업을 wait_for_completion 매개변수를 false로 지정해 비동기로 처리할 수 있다.
•
ES에선 작업을 task로 등록하고 task의 id를 응답에 포함시켜 반환한다.
•
클라이언트는 이 taskId를 통해 작업 진행상황을 조회하거나 취소할 수 있다.
POST [인덱스 이름]/_update_by_query?wait_for_completion=false
{
//...
}
# 응답
{
"task": "Iqb0AujZQViife0-AOlyPg:1650433"
}
# task 상태 확인
GET .tasks/_doc/[task id]
GET _tasks/[task id]
# task 작업 취소
POST _tasks/[task id]/_cancel
# task 결과 삭제
DELETE .tasks/_doc/[task id]
Bash
복사
슬라이싱
•
스로틀링으로 부하를 줄이는 대신 업데이트 성능을 올려 빠른 시간내에 작업을 끝내고자 할 때 선택
POST [인덱스 이름]/_update_by_query?slices=auto
{
//...
}
Bash
복사
•
기본값은 1로 작업을 병렬로 쪼개지 않는다는 의미
•
auto로 지정하면 보통 지정한 인덱스의 주 샤드 수만큼 지정된다.
delete by query
•
update by query처럼 지정한 검색 쿼리로 삭제할 대상을 지정한 뒤 삭제를 수행한다.
•
동작 방식이나 충돌 처리, 비동기 처리등에 대한 속성은 update by query와 동일하다.
POST [인덱스 이름]/_delete_by_query
{
"query":{
//...
}
}
Bash
복사
검색
GET [인덱스 이름]/_search
POST [인덱스 이름]/_search
GET _search
POST _search
Bash
복사
•
index 이름은 하나 이상을 작성할 수 있고 와일드 카드(*)사용도 가능하다.
◦
GET my_index*,analyzer_test*,mapping_test/_search
쿼리 DSL 검색, 쿼리 문자열 검색
•
쿼리 DSL 검색
: query 필드에 원하는 쿼리와 질의를 작성해서 호출할 수 있다.
GET my_index/_search
{
"query": {
"match": {
"title": "hello"
}
}
}
Bash
복사
•
쿼리 문자열 검색
: 루씬 쿼리 문자열을 지정하는 방법으로 수행하는 방법
GET my_index/_search?q=title:hello
Bash
복사
◦
기타 문법
문법 | 설명 | 예시 |
질의어만 기술 | 전체 필드 검색 | hello |
필드이름:질의어 | 지정 필드 대상 검색 | title:hello
title:(hello OR world) |
_exists_:필드이름 | 특정 필드가 존재하는 문서 검색 | _exists_:title |
필드이름:[시작 to 끝]
필드이름:{시작 to 끝} | 범위 검색, 경계값이 없으면 *을 사용한다. | data:[2021-05-03 to 2021-09-03]
count:{10 to 20}
date:{* to 2021-09-03}
count:[20 to *] |
질의어 * or ? | 와일드 카드를 포함한 쿼리는 매우 느리고 위험(사용 비권장) | title:hello* |
AND, OR, NOT, ( ) | 쿼리에 연산 적용, ( ) 로 연산 순서 지정 | (title:(hello OR world)) AND
(contents: NOT bye) OR
count: [1 to 3] |
match 쿼리
•
지정한 필드의 내용이 질의어와 매치되는 문서를 찾는 쿼리
•
필드가 text라면 필드의 값과 질의어 모두 애널라이저로 분석된다.
GET my_index/_search
{
"query": {
"match": {
"fieldName": {
"query": "test query sentence"
}
}
}
}
Bash
복사
•
fieldName 필드가 text타입이고 기본 애널라이저(standard)라면 질의어(test query sentence)는 test, query, sentence 총 3개의 토큰으로 분석될 것이다.
•
default는 OR 검색이다. AND로 바꾸고 싶다면 operator 속성을 and로 지정하면 된다.
term 쿼리
•
지정한 필드의 값이 질의어와 일치하는 문서를 찾는 쿼리
GET my_index/_search
{
"query": {
"term": {
"fieldName": {
"value": "hello"
}
}
}
}
Bash
복사
•
지정할 필드가 하나 이상이라면 term대신 terms를 사용하면 된다.
GET my_index/_search
{
"query": {
"terms": {
"fieldName": ["hello", "world"]
}
}
}
Bash
복사
range 쿼리
•
범위 검색 쿼리
GET [인덱스 이름]/_search
{
"query": {
"range": {
"fieldName": {
"gte": 100,
"lt": 200
}
}
}
}
Bash
복사
•
gt(greater than) lt(less than)
gte(greater than or equal to) lte(less than or equal to)
•
역시 부하가 크기에 부담이 없는 상황에서만 사용해야 한다.
prefix 쿼리
•
필드의 값이 지정한 질의어로 시작하는 문서 검색
GET [인덱스 이름]/_search
{
"query": {
"prefix": {
"fieldName": {
"value": "hello"
}
}
}
}
Bash
복사
•
무거운 쿼리로 분류되며 단발성 쿼리로 가끔 수행한다면 괜찮지만 일상 쿼리로는 적절치 않다.
•
매핑에 index_prefixs 설정을 추가해 길이 제한을 해서 성능을 높힐 수 있다.
PUT prefix_mapping_test
{
"mappings": {
"properties": {
"prefixField": {
"type": "text"
"index_prefixes": {
"min_chars":3,
"max_chars":5,
}
}
}
}
}
Bash
복사
exists 쿼리
•
필드가 존재하는 문서를 검색한다.
GET [인덱스 이름]/_search
{
"query": {
"exists": {
"field": "fieldName"
}
}
}
Bash
복사
bool 쿼리
•
쿼리 조합 검색 쿼리
GET _search
{
"query": {
"bool": {
"must": [
{"term": {"field1": {"value": "hello"}}},
{"term": {"field2": {"value": "world"}}}
],
"must_not": [
{"term": {"field4": {"value": "elasticsearch-test"}}}
],
"filter":[
{"term": {"field3": {"value": true}}}
],
"should": [
{"match": {"field4": {"query": "elasticsearch"}}},
{"match": {"field5": {"query": "lucene"}}}
],
"minimum_should_match": 1
}
}
}
Bash
복사
•
must, must_not, filter, shoud 조건절을 이용해 다른 쿼리와 조합할 수 있다.
◦
must, filter 조건절에 들어간 하위 쿼리는 AND 조건으로 만족해야 한다.
◦
must_not 조건절을 만족하는 쿼리는 결과에서 제외된다.
◦
should 조건절에 들어간 쿼리는 minimum_should_match 에 지정한 개수 이상의 하위 쿼리를 만족하는 문서가 포함된다.
검색 결과 정렬
•
검색 요청 payload에 sort를 지정해 검색 결과 정렬이 가능하다.
GET [인덱스 이름]/_search
{
"query": { ... },
"sort": [
{"field1": { "order":"desc"} },
{"field2": { "order":"asc"} },
"field3"
}
}
Bash
복사
•
정렬 필드는 여럿 지정이 가능하며 필드명만 지정해도 내림차순 정렬을 한다.
•
text 타입은 정렬대상으로 하지 않도록 하자.
•
_score를 정렬 순서에 포함시켜 유사도 정렬도 가능하다.
•
_doc을 정렬 순서에 포함시켜 문서 번호로 정렬할 수 있다.
페이지네이션
•
from과 size
GET [인덱스 이름]/_search
{
"from": 10, # 11번째부터 (default: 0)
"size": 5, # 16번째까지 (default: 10)
"query": { //... }
}
Bash
복사
◦
from 15 / size 5로 지정하면, 20개의 문서를 검색한 뒤 마지막 5개를 잘라서 반환한다.
◦
from절이 커질수록 검색해야하는 범위가 커진다. (무거워진다.)
◦
다음 페이지를 검색하는사이에 새로운 값이 추가되거나 삭제될 수 있어 일관성이 떨어진다.
◦
정확한 페이지네이션을 위해서는 from/size는 권장하지 않는다.
◦
ES에선 from + size가 1만이 넘는 검색은 수행이 거부 된다.
•
scroll
: 검색 조건에 매칭되는 전체 문서 순회시 사용하는 방법으로 스크롤 순회도중에는 최초 검색시의 문맥(search context)가 유지된다.
GET [인덱스 이름]/_search?scroll=1m
{
"size": 1000,
"query": { //... }
}
Bash
복사
◦
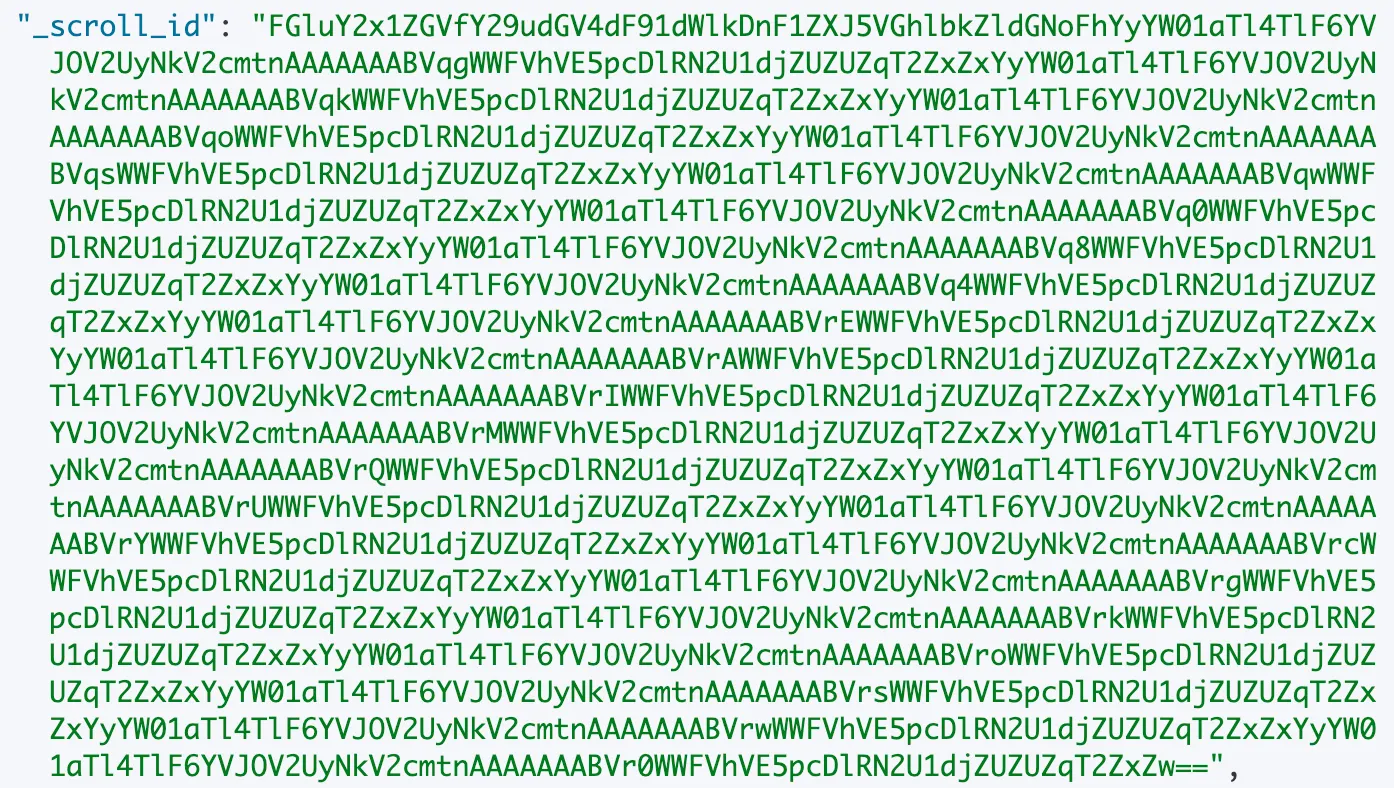
scroll을 사용하면 검색 결과에서 scroll_id를 확인할 수 있는데, 두 번째 검색부터는 이 scroll_id를 지정해서 scroll 검색을 수행하면 된다.
GET [인덱스 이름]/_search/scroll
{
"scroll_id": "FGluY2x1ZGVfY29....",
"scroll": "1m"
}
Bash
복사
◦
scroll 검색을 수행할 때마다 검색 문맥은 연장된다.
◦
검색 문맥이 유지되고 있지만 더 빠르게 자원반납을 하고 싶다면 delete로 제거해줄수도 있다.
◦
scroll은 보통 정렬 여부가 상관없는 경우에 사용하기에 정렬을 _doc으로 지정하는게 좋다.
▪
유사도 점수 계산도 하지 않고 정렬을 위한 별도의 자원도 사용하지 않기 때문
GET [인덱스 이름]/_search?scroll=1m
{
"size": 1000,
"query": { //... },
"sort":["_doc"]
}
Bash
복사
◦
search_after
▪
서비스에서 사용자에게 제공하는 페이지네이션은 search_after를 사용하는게 좋다.
▪
sort를 지정하며 동일한 정렬 값이 나오지 않게 1개 이상의 동점 제거(tiebreaker)용 필드를 지정해야 한다.
GET kibana_sample_data_ecommerce/_search
{
"size":20,
"query": {
"term": {
"currency": {
"value":"EUR"
}
}
},
"search_after": [1706992790000,"591924"],
"sort": [
{
"order_date":"desc"
},
{
"order_id":"asc"
}
]
}
# response
{
...
"sort": [1706992790000,"591924"]
...
}
Bash
복사
▪
동점 제거용 필드는 문서를 고유하게 특정할 수 있는 값이 들어가야 한다.
•
id는 doc_values가 꺼져있기에 비권장
•
차라리 id와 동일한 값을 별도로 필드에 저장해서 동점제거용으로 쓰는게 낫다.
▪
인덱스 상태가 변하는 도중 페이지네이션은 문서 누락이 발생할 수 있기에point in time API를 조합해 사용한다.
◦
search_after - point in time API
▪
keep_alive 매개변수로 지정한 시간만큼 검색 대상의 상태를 고정한다.
POST kibana_sample_data_ecommerce/_pit?keep_alive=1m
# response
{
"id": "gcSHBAEca2liYW5hX3NhbXBsZV9kYXRhX2Vjb21tZXJjZRYzVktwbzJBU1M0V3JTd29remI0YWRBABZYVWFUTmlwOVE3ZTV2NlRlRmpPZnFnAAAAAAAAAXuDFjJhbTVpOXhOUXphUk5XZTI2RXZya2cAARYzVktwbzJBU1M0V3JTd29remI0YWRBAAA="
}
Bash
복사
이 pit id를 search_after에 활용할 수 있다.
GET _search
{
"size":20,
"query": {
"term": {
"currency": {
"value":"EUR"
}
}
},
"pit": {
"id": "gcSHBAEca2liYW5hX3NhbXBsZV9kYXRhX2Vjb21tZXJjZRYzVktwbzJBU1M0V3JTd29remI0YWRBABZYVWFUTmlwOVE3ZTV2NlRlRmpPZnFnAAAAAAAAAXuDFjJhbTVpOXhOUXphUk5XZTI2RXZya2cAARYzVktwbzJBU1M0V3JTd29remI0YWRBAAA",
"keep_alive": "1m"
},
"search_after": [1706992790000,"591924"],
"sort": [
{
"order_date":"desc"
}
]
}
Bash
복사
▪
pit id로 검색 대상이 지정되서 인덱스 지정이 불필요하다.
집계
•
aggs 속성을 이용해 집계를 진행할 수 있다.
: 집계에서는 모든 문서가 사용되기에 size 속성은 0으로 설정하도록 하자.
GET kibana_sample_data_ecommerce/_search
{
"size":0,
"query": {
"term": {
"currency": {
"value":"EUR"
}
}
},
"aggs": {
"my-sum-aggregation-name": {
"sum": {
"field": "taxless_total_price"
}
}
}
}
Bash
복사
# response
{
...
"aggregations": {
"my-sum-aggregation-name": {
"value": 350884.12890625
}
}
}
Bash
복사
•
집계는 검색 쿼리에 매칭되는 모든 문서를 대상으로 하기에 과도한 집계는 성능 저하를 유발한다.
•
ES 집계에는 메트릭, 버킷, 파이프라인 집계로 분류된다.
집계 - 메트릭 집계
•
avg, max, min, sum 집계로 대상 필드의 집계를 구할 수 있다.
•
stats 집계로 대상 필드의 평균,최댓값,최솟값,합,개수를 모두 계산할 수 있다. (한번에)
•
cadinality 집계로 해당 필드의 카디널리티를 집계할 수 있다.
◦
precision_threshold(default: 3000) 속성을 추가해 정확도를 조절할 수 있다.
◦
정확도를 올릴 수록 메모리를 사용하기에 최종 카디널리티보다 높은 수준으로 유지하는게 좋다.
집계 - 버킷 집계
•
문서를 특정 기준으로 분리해 부분집하으로 만들고, 이에 대해 하위 집계(sub-aggregation)을 수행한다.
•
range 집계로 원하는 버킷 구간을 직접 지정할 수 있다.
{
...
"aggs": {
"distance-kilometers-range": {
"range": {
"field": "DistanceKilometers",
"ranges": [
{ "to": 5000 }, { "from": 5000, "to", 10000 }, { "from": 10000 }
]
}
},
"aggs": {
"average-ticket-price": {
"avg": {
"field": "AvgTicketPrice"
}
}
}
}
Bash
복사
◦
각각의 버킷 내에서 AvgTicketPrice라는 필드의 평균값을 구한다.
•
data_range 집계로 date 타입에 대한 집계도 가능하다.
◦
시간 계산식을 사용할 수 있다.
◦
now와 같이 호출시점에 값이 달라지는 집계 요청은 샤드 요청 캐시에 캐싱되지 않는다.
•
histogram 집계는 범위의 시작-끝이 아니라 간격을 지정해서 버킷을 만들어 집계한다.
◦
지정 필드의 최소값-최대값을 구한뒤 interval 간격으로 버킷을 분리한다.
◦
offset을 이용해 위치 조정도 가능하다.
GET _search
{
"size":0,
"query": { "match_all": {}},
"aggs": {
"my-histogram": {
"histogram": {
"field": "DistanceKilometers",
"interval": 1000
}
}
}
}
# response
"aggregations": {
"my-histogram": {
"buckets": [
{
"key": 0,
"doc_count": 1799
},
{
"key": 1000,
"doc_count": 1148
},
{
"key": 2000,
"doc_count": 529
},
...
}
}
Bash
복사
GET _search
{
"size":0,
"query": { "match_all": {}},
"aggs": {
"my-histogram": {
"histogram": {
"field": "DistanceKilometers",
"interval": 1000,
"offset": 50
}
}
}
}
# response
"aggregations": {
"my-histogram": {
"buckets": [
{
"key": -950,
"doc_count": 641
},
{
"key": 50,
"doc_count": 1226
},
{
"key": 1050,
"doc_count": 1106
},
...
]
}
}
Bash
복사
offset이 50이면 [0, 50] 구간이 포함될 버킷이 필요해 [-950, 50] 구간이 생긴다.
•
date 타입도 data_histogram으로 버킷 집계가 가능하다.
◦
구간 설정 속성은 interval이 아닌 calendar_interva | fixed_interval을 사용한다.
•
terms 집계로 지정 필드에 대해 가장 빈도수가 높은 term 순서대로 버킷을 생성한다.
◦
size속성으로 버킷 생성 갯수를 지정한다.
GET kibana_sample_data_logs/_search
{
"size": 0,
"query": { "match_all": {}},
"aggs": {
"my-terms-aggs": {
"terms": {
"field": "host.keyword",
"size": 10
}
}
}
}
# response
{
...
"aggregations": {
"my-terms-aggs": {
"doc_count_error_upper_bound": 0, #doc_count의 오차 상한선
"sum_other_doc_count": 0, # 버킷에 포함되지 않은 문서 수
"buckets": [
{
"key": "artifacts.elastic.co",
"doc_count": 6488
},
{
"key": "www.elastic.co",
"doc_count": 4779
},
{
"key": "cdn.elastic-elastic-elastic.org",
"doc_count": 2255
},
{
"key": "elastic-elastic-elastic.org",
"doc_count": 552
}
]
}
}
}
Bash
복사
•
모든 term에 대한 페이지네이션으로 전체 순회하며 집계를 하고 싶다면 composite 집계 사용이 좋다.
◦
composite 집계는 sources로 지정된 하위 집계 버킷 전부 페이지네이션을 이용해 순회하는 집계
GET kibana_sample_data_logs/_search
{
"size": 0,
"query": { "match_all": {}},
"aggs": {
"composite_aggs": {
"composite": {
"size": 100, # 페이지네이션에서 한 번에 반환할 버킷 갯수
"sources": [
{
"terms-aggs": {
"terms": {
"field": "host.keyword"
}
}
},
{
"data-histogram-aggs": {
"date_histogram": {
"field": "@timestamp",
"calendar_interval": "day"
}
}
}
]
}
}
}
}
Bash
복사
집계 - 파이프라인 집계
•
집계 결과를 집계 대상으로 수행한다.
•
buckets_path 속성으로 다른 집계의 결과를 가져오며 상대 경로로 지정된다.
◦
>: 하위 집계로 이동하는 구분자
◦
.: 하위 메트릭으로 이동하는 구분자
◦
집계 이름
◦
메트릭 이름
•
cumulative_sum 집계로 다른 집계의 값을 누적해 합산한다.
GET kibana_sample_data_ecommerce/_search
{
"size": 0,
"query": { "match_all": {}},
"aggs": {
"daily-timestamp-bucket": {
"date_histogram": {
"field":"order_date",
"calendar_interval": "day"
},
"aggs": {
"daily-total-quantity-average": {
"avg": {
"field": "total_quantlty"
}
},
"pipeline-sum": {
"cumulative_sum": {
"buckets_path": "daily-total-quantity-average"
}
}
}
}
}
}
Bash
복사
•
max_bucket 집계로 가장 값이 큰 버킷의 key와 결과값을 구할 수 있다.
GET kibana_sample_data_ecommerce/_search
{
"size": 0,
"query": { "match_all": {}},
"aggs": {
"daily-timestamp-bucket": {
"date_histogram": {
"field":"order_date",
"calendar_interval": "day"
},
"aggs": {
"daily-total-quantity-average": {
"avg": {
"field": "total_quantity"
}
}
}
},
"max-total-quantity": {
"max_bucket": {
"buckets_path": "daily-timestamp-bucket>daily-total-quantity-average"
}
}
}
}
# response
{
...
"max-total-quantity": {
"value": 2.289473684210526,
"keys": [
"2024-02-02T00:00:00.000Z"
]
}
}
Bash
복사
ES Client 사용하기


•
JVM용 클라이언트
◦
저수준 REST 클라이언트
▪
HTTP 기반 ES 통신 클라이언트
▪
Request, Response 데이터에 대한 가공 작업은 사용자가 직접 해야 한다.
◦
고수준 REST 클라이언트 | 자바 클라이언트
▪
둘 다 저수준 REST 클라이언트를 래핑해서 만들었다.
▪
고수준 클라이언트는 7.15부터 지원 중단
▪
자바클라이언트는 개발초기라서 고수준 클라이언트와 혼용해서 사용한다.

즉, ES 8이상이라면 그냥 자바 클라이언트를 사용하도록 하자
1.
의존성 추가
implementation 'com.fasterxml.jackson.core:jackson-databind:2.16.1'
implementation 'co.elastic.clients:elasticsearch-java:8.11.4'
implementation 'com.fasterxml.jackson.module:jackson-module-kotlin:2.16.1'
implementation 'com.fasterxml.jackson.datatype:jackson-datatype-jsr310:2.16.1'
Groovy
복사
•
jackson-databind : 자바 객체 to JSON 직렬화 및 역직렬화 라이브러리
•
elasticsearch-java: ES 자바 클라이언트 라이브러리
•
jackson-module-kotlin: jackson 코틀린 지원 라이브러리
•
jackson-datatype-jsr310: ZonedDateTime, LocalDateTime과 같은 JSR-310 날짜 객체 처리용 라이브러리
2.
클라이언트 초기화
private fun getEsClient(): ElasticsearchClient {
// Elasticsearch REST 클라이언트 빌더 생성
val restClientBuilder = RestClient.builder(
HttpHost("localhost", 9200, "http")
)
// 빌더를 사용하여 낮은 수준의 REST 클라이언트 인스턴스 생성
val lowLevelRestClient = restClientBuilder.build()
// Jackson JSON 매퍼 구성. Java 8 날짜/시간 API 모듈 추가 및 몇 가지 옵션 설정
val mapper = jacksonMapperBuilder()
.addModule(JavaTimeModule()) // Java 8 날짜/시간 모듈 추가
.configure(SerializationFeature.WRITE_DATES_AS_TIMESTAMPS, false) // 날짜를 타임스탬프로 쓰지 않도록 설정
.configure(DeserializationFeature.FAIL_ON_UNKNOWN_PROPERTIES, false) // 알 수 없는 속성에 대해 실패하지 않도록 설정
.build()
// Jackson JSON 매퍼를 사용하여 REST 클라이언트 트랜스포트 설정
val transport = RestClientTransport(lowLevelRestClient, JacksonJsonpMapper(mapper))
// 최종적으로 Elasticsearch 클라이언트 인스턴스 반환
return ElasticsearchClient(transport)
}
Kotlin
복사
3.
테스트용 객체 생성
data class MyIndexClass(
val fieldOne: String,
val fieldTwo: Long,
val fieldThree: ZonedDateTime
)
data class MyPartialIndexClass(
val fieldOne: String
)
Kotlin
복사
4.
문서 색인 및 조회해보기
// 색인
private fun indexExample(client: ElasticsearchClient) {
val indexResponse = client.index { builder ->
builder
.index("my-index") //색인 요청 함수 index
.id("my-id-1")
.routing("my-routing-1")
.document(MyIndexClass("hello", 2L, ZonedDateTime.now(ZoneOffset.UTC)))
}
val result = indexResponse.result()
println("result: $result")
}
// 조회
private fun getExample(client: ElasticsearchClient) {
val request = GetRequest.Builder()
.index("my-index")
.id("my-id-1")
.routing("my-routing-1")
.build()
client.get(request, MyIndexClass::class.java)
.run { println("result: $this") }
}
Kotlin
복사
5.
bulk API 사용해보기
// Builder Pattern을 사용한 bulk API
private fun bulkExampleOne(client: ElasticsearchClient) {
val createOperation = CreateOperation.Builder<MyIndexClass>()
.index("my-index")
.id("my-id-2")
.routing("my-routing-2")
.document(MyIndexClass("world", 2L, ZonedDateTime.now(ZoneOffset.UTC)))
.build()
val indexOperation = IndexOperation.Builder<MyIndexClass>()
.index("my-index")
.id("my-id-3")
.routing("my-routing-3")
.document(MyIndexClass("world", 4L, ZonedDateTime.now(ZoneOffset.UTC)))
.build()
val updateAction = UpdateAction.Builder<MyIndexClass, MyPartialIndexClass>()
.doc(MyPartialIndexClass("world updated"))
.build()
val updateOperation = UpdateOperation.Builder<MyIndexClass, MyPartialIndexClass>()
.index("my-index")
.id("my-id-1")
.routing("my-routing-1")
.action(updateAction)
.build()
val bulkOne = BulkOperation.Builder().create(createOperation).build()
val bulkTwo = BulkOperation.Builder().index(indexOperation).build()
val bulkThree = BulkOperation.Builder().update(updateOperation).build()
val operations = listOf(bulkOne, bulkTwo, bulkThree)
val response = client.bulk { it.operations(operations) }
response.items().forEach {
println("result: ${it.result()}, error: ${it.error()}")
}
}
// Functional Call Pattern을 사용한 bulk API
private fun bulkExampleTwo(client: ElasticsearchClient) {
val bulkResponse = client.bulk { _0 ->
_0
.operations { _1 ->
_1
.index { _2: IndexOperation.Builder<MyIndexClass> ->
_2
.index("my-index")
.id("my-id-4")
.routing("my-routing-4")
.document(MyIndexClass("world", 4L, ZonedDateTime.now(ZoneOffset.UTC)))
}
}
.operations { _1 ->
_1
.update { _2: UpdateOperation.Builder<MyIndexClass, MyPartialIndexClass> ->
_2
.index("my-index")
.id("my-id-2")
.routing("my-routing-2")
.action { _3 ->
_3
.doc(MyPartialIndexClass("world updated"))
}
}
}
}
bulkResponse.items().forEach {
println("result: ${it.result()}, error: ${it.error()}")
}
}
Kotlin
복사
•
Functional Call Pattern을 사용한 함수에서 _0, _1과 같은 이름을 사용했는데 이는 스칼라 공식 문서에서 람다의 깊이에 따른 네이밍 권장사항이다.
6.
검색 API 사용해보기
private fun searchExample(client: ElasticsearchClient) {
val response = client.search({ builder ->
builder
.index("my-index")
.from(0)
.size(10)
.query { query -> query
.term { term -> term
.field("fieldOne")
.value { value -> value.stringValue("world") }
}
}
}, MyIndexClass::class.java)
response.hits().hits().forEach {
println("result: $it")
}
}
Kotlin
복사
7.
BulkIngester 사용하기
: ES 8.7부터 자바 클라이언트에 추가된 BulkIngester는 고수준 REST Client의 BulkProcessor를 대체하는 기능으로 여러 문서에 관련된 작업들을 한 번에 ES로 요청하는 기능
// 대량(bulk) 작업의 생명 주기를 관리하는 리스너
class BulkIngestListener<Context> : BulkListener<Context> {
override fun beforeBulk(executionId: Long, request: BulkRequest?, contexts: MutableList<Context>?) {
println("[${LocalDateTime.now()}] beforeBulk - executionId: $executionId")
}
override fun afterBulk(
executionId: Long,
request: BulkRequest?,
contexts: MutableList<Context>?,
response: BulkResponse?
) {
println(
"[${LocalDateTime.now()}] " +
"afterBulk - executionId: $executionId, " +
"itemSize: [${response?.items()?.size}], " +
"took : ${response?.took()}, " +
"errors: ${response?.errors()}"
)
}
// 작업이 완료되기전 혹은 오류가 발생한 후 호출하는 메서드
override fun afterBulk(
executionId: Long,
request: BulkRequest?,
contexts: MutableList<Context>?,
failure: Throwable?
) {
System.err.println(failure)
}
}
private fun bulkIngesterExample(client: ElasticsearchClient) {
val listener = BulkIngestListener<String>()
val ingester = BulkIngester.of<String> {
it.client(client) // Elasticsearch 클라이언트를 설정합니다.
.maxOperations(200) // 대량 작업에서 처리할 최대 작업 수를 설정합니다. 이 값이 너무 낮으면 오버헤드가 증가하고, 너무 높으면 메모리 문제가 발생할 수 있습니다
.maxConcurrentRequests(1) // 동시에 처리할 최대 요청 수를 설정합니다. 이 값은 Elasticsearch 클러스터의 용량과 원하는 병렬 수준에 따라 설정해야 합니다
.maxSize(5242880L) // 대량 요청의 최대 크기를 바이트 단위로 설정합니다. 이 값은 사용 가능한 메모리와 문서의 크기에 따라 설정해야 합니다
.flushInterval(5L, TimeUnit.SECONDS) // 대량 요청이 실행되는 간격을 설정합니다. 이 간격은 작업 수나 요청 크기에 상관없이 적용됩니다
.listener(listener) // 대량 작업의 생명주기를 관리하는 리스너를 설정합니다.
}
for (number in 0L until 1100L) {
val bulkOperation = BulkOperation.of { bulkBuilder ->
bulkBuilder.index { indexOpBuilder: IndexOperation.Builder<MyIndexClass> ->
indexOpBuilder
.index("my-index")
.id("my-id-$number")
.routing("my-routing-$number")
.document(MyIndexClass("world", number, ZonedDateTime.now(ZoneOffset.UTC)))
}
}
ingester.add(bulkOperation)
}
println("[${LocalDateTime.now()}] sleep 10 seconds ...")
Thread.sleep(10000L)
for (number in 1100L until 1200L) {
val bulkOperation = BulkOperation.of { bulkBuilder ->
bulkBuilder.index { indexOpBuilder: IndexOperation.Builder<MyIndexClass> ->
indexOpBuilder
.index("my-index")
.id("my-id-$number")
.routing("my-routing-$number")
.document(MyIndexClass("world", number, ZonedDateTime.now(ZoneOffset.UTC)))
}
}
ingester.add(bulkOperation)
}
println("[${LocalDateTime.now()}] sleep 10 seconds ...")
Thread.sleep(10000L)
ingester.close()
}
Kotlin
복사
•
.maxOperations(200)
◦
대량 작업에서 처리할 최대 작업 수를 설정합니다.
◦
이 값이 너무 낮으면 오버헤드가 증가하고, 너무 높으면 메모리 문제가 발생할 수 있습니다
•
.maxConcurrentRequests(1)
◦
동시에 처리할 최대 요청 수를 설정합니다.
◦
이 값은 Elasticsearch 클러스터의 용량과 원하는 병렬 수준에 따라 설정해야 합니다
•
.maxSize(5242880L)
◦
대량 요청의 최대 크기를 바이트 단위로 설정합니다.
◦
이 값은 사용 가능한 메모리와 문서의 크기에 따라 설정해야 합니다
•
.flushInterval(5L, TimeUnit.SECONDS)
◦
대량 요청이 실행되는 간격을 설정합니다.
◦
이 간격은 작업 수나 요청 크기에 상관없이 적용됩니다
•
listener(listener)
◦
대량 작업의 생명주기를 관리하는 리스너를 설정합니다.